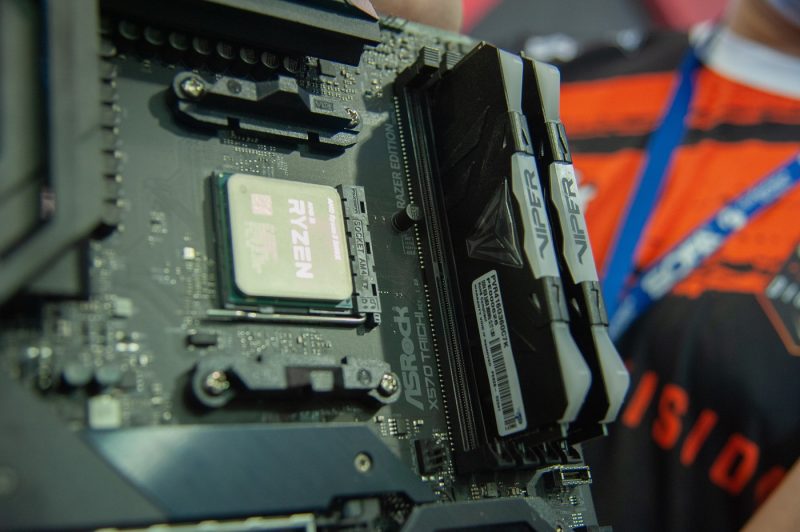
Prototipurile moderne pot rula modele lingvistice mari pe hardware cu grafică integrată, arată un experiment comparativ realizat pe trei configurații AMD, de la un sistem vechi basat pe Ryzen 5 5600G la un dispozitiv de ultimă generație cu Ryzen AI Max 390. Testele au evidențiat diferențe semnificative de viteză și performanțe între aceste platforme, dar și posibilitatea de a utiliza modele AI fără placă video dedicată.
Rezumatul experimentului
Trei configurații AMD au fost folosite pentru a testa rularea modelelor lingvistice mari. ASUS ROG Flow Z13 cu Ryzen AI Max 390 și grafică integrată Radeon 8050S a obținut cele mai bune rezultate, în timp ce Lenovo Legion Go cu Ryzen Z1 Extreme și grafică Radeon 780M și sistemul desktop cu Ryzen 5 5600G și GPU Vega 7 au înregistrat performanțe mai slabe. Testele au măsurat viteza de generare a textului, procesarea prompturilor, timpul de rulare, consumul de energie și temperaturile maxime atinse.
Echipamentele utilizate
ASUS ROG Flow Z13 avea 32 GB memorie RAM partajată și un procesor Ryzen AI Max 390 cu grafică Radeon 8050S, o configurație considerată de top printre dispozitivele cu grafică integrată. Lenovo Legion Go, din prima generație, avea 16 GB de RAM și folosea GPU-ul Radeon 780M, cu performanțe mai bune decât generatiile anterioare, dar inferior față de Ryzen AI Max 390. Sistemul de desktop cu Ryzen 5 5600G includea memorie integrată și GPU Vega 7, fiind mai vechi și neavând suport oficial pentru platforma ROCm, destinată calculului GPU.
Performanța modelelor
Testele au arătat că Radeon 8050S a atins o viteză de 85,1 tokenuri pe secundă în generarea de text, de aproape cinci ori mai rapid decât Vega 7, care a ajuns la 17,5 tokenuri pe secundă. Lenovo Legion Go, cu Radeon 780M, a avut un rezultat de 44,1 tokenuri pe secundă. La procesarea prompturilor, ASUS a atins 1.609 tokenuri pe secundă, în timp ce Legion Go a avut 783, iar Vega 7 doar 201 tokenuri pe secundă. Testul pe procesorul Ryzen Z1 Extreme, fără GPU, a obținut 22,4 tokenuri pe secundă la generarea textului și 150 tokenuri pe secundă la procesare.
Timpul de rulare la generare a textului a fost de 3,2 secunde pentru ASUS ROG Flow Z13, 6,3 secunde pentru Legion Go și 13,7 secunde pentru sistemul cu Ryzen Z1 Extreme. Varianta cu Vega 7 a avut nevoie de 16,8 secunde.
Impactul memoriei partajate și limitările hardware
Grafică integrată permite accesul la memoria RAM partajată, ceea ce poate fi util pentru modele ce necesită multă memorie. În cazul sistemului cu Ryzen 5 5600G, memoria a fost setată manual la 16 GB, fără o îmbunătățire semnificativă a performanței, arătând că puterea de calcul a GPU-ului este un factor determinant. Configurațiile cu Vega 7 au fost ajustate software pentru a putea rula modelele, folosind backendul Vulkan din cauza lipsei suportului ROCm.
Consumul de energie și temperaturile în testare
Cel mai performant sistem, Ryzen AI Max 390, a consumat în medie 64 W și a atins o temperatură maximă de 95 de grade Celsius. Pentru sistemul cu Radeon 780M, consumul a fost de 33 W, temperatura maximă de 81 de grade. Vulnerabilitatea termică a fost mai accentuată pe platforma modernă, în timp ce sistemul cu Vega 7 a necesitat un management termic mai redus, atingând 57 de grade în timpul testului.
Concluzii
Rezultatele demonstrează că modelele lingvistice mari pot fi rulate pe hardware cu grafică integrată, deși diferențele de performanță rămân considerabile. Variantele moderne, precum Ryzen AI Max 390, oferă viteze mult superioare, însă pot avea costuri financiare ridicate și limitări de extindere. Usurinta de a rula astfel de modele pe dispozitive portabile cu sisteme mai vechi, dar cu hardware compatibil, arată evoluția tehnologiei GPU-urilor integrate.

